En intelligence artificielle, le fine tuning consiste à poursuivre l'entraînement d'un modèle déjà prêt sur un petit jeu d'exemples choisis, pour qu'il adopte un comportement précis. On le traduit parfois par « réglage fin » ou « ajustement fin ». Il s'applique surtout aux grands modèles de langage (LLM).
La question utile n'est pas « comment fine-tuner », les éditeurs documentent très bien la technique, mais « faut-il le faire ». Souvent, la réponse est non : une consigne mieux construite ou un accès à vos documents règle le problème plus vite. Voici de quoi trancher, sans une ligne de code.
Le fine tuning, c'est quoi ?
Une définition en une phrase
Le fine tuning est un entraînement complémentaire, appliqué à un modèle pré-entraîné, qui ajuste ses paramètres internes à partir de quelques dizaines ou centaines d'exemples de ce que vous attendez de lui.
Imaginez un collaborateur qui maîtrise déjà la langue et son métier. Vous lui faites lire 500 tickets de service client traités par vos meilleurs conseillers : il en ressort avec votre ton et vos formules. Il ne connaît pas pour autant vos tarifs de l'an prochain.
Trois leviers reviennent dès qu'on parle d'adapter un modèle d'IA générative :
- Le prompt engineering, c'est le travail sur la consigne envoyée au modèle, sans rien modifier en lui.
- Le RAG (retrieval augmented generation), c'est le fait de retrouver des passages dans vos documents et de les remettre au modèle au moment de la question.
- Le fine tuning, c'est un entraînement supplémentaire qui modifie le modèle lui-même à partir d'exemples.
Ce que le fine tuning change dans un modèle, et ce qu'il ne fait pas
Un modèle de langage est un immense ensemble de valeurs numériques, ses poids. Le fine tuning les déplace légèrement dans la direction de vos exemples, et vous obtenez un nouveau modèle, privé. Le prompt et le RAG, eux, n'agissent que sur ce que le modèle reçoit au moment de la question.
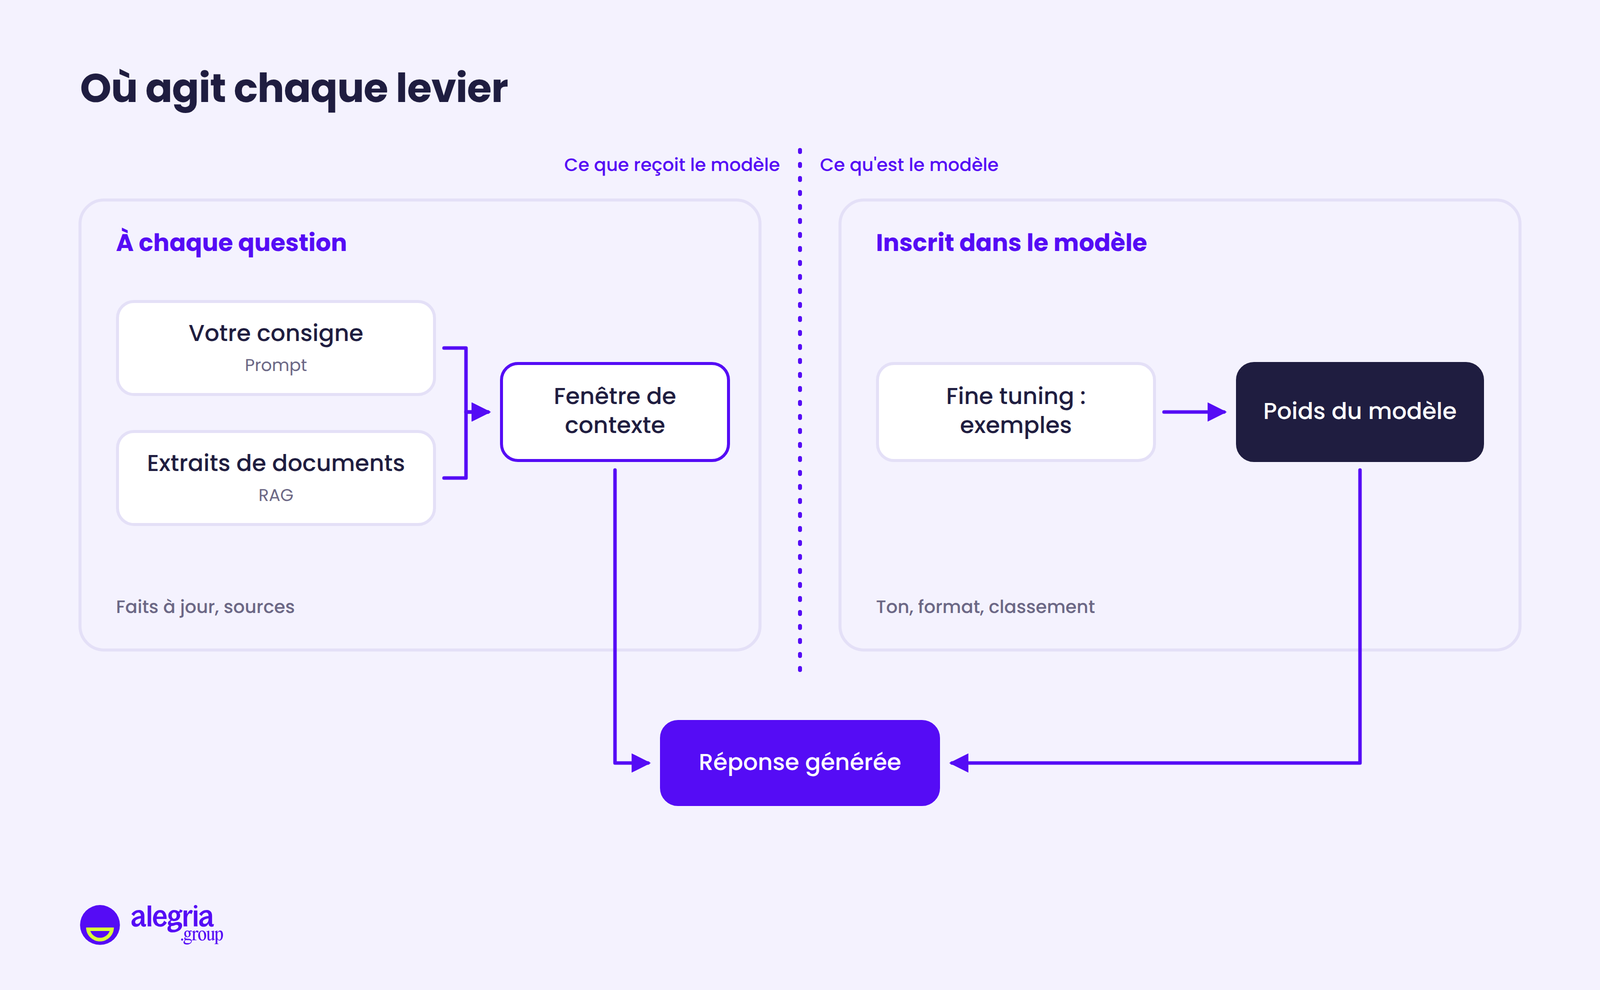
Ce qui change : le ton, le format, la manière de traiter un type de demande, le choix entre plusieurs catégories. Ce qui ne change pas de façon fiable : ce que le modèle sait.
Le fine tuning n'est pas un remède aux hallucinations. Un modèle ajusté sur vos réponses de support peut inventer un délai de remboursement avec le ton maison, ce qui rend l'erreur plus difficile à repérer.
Fine tuning ou prompt engineering : la limite des consignes
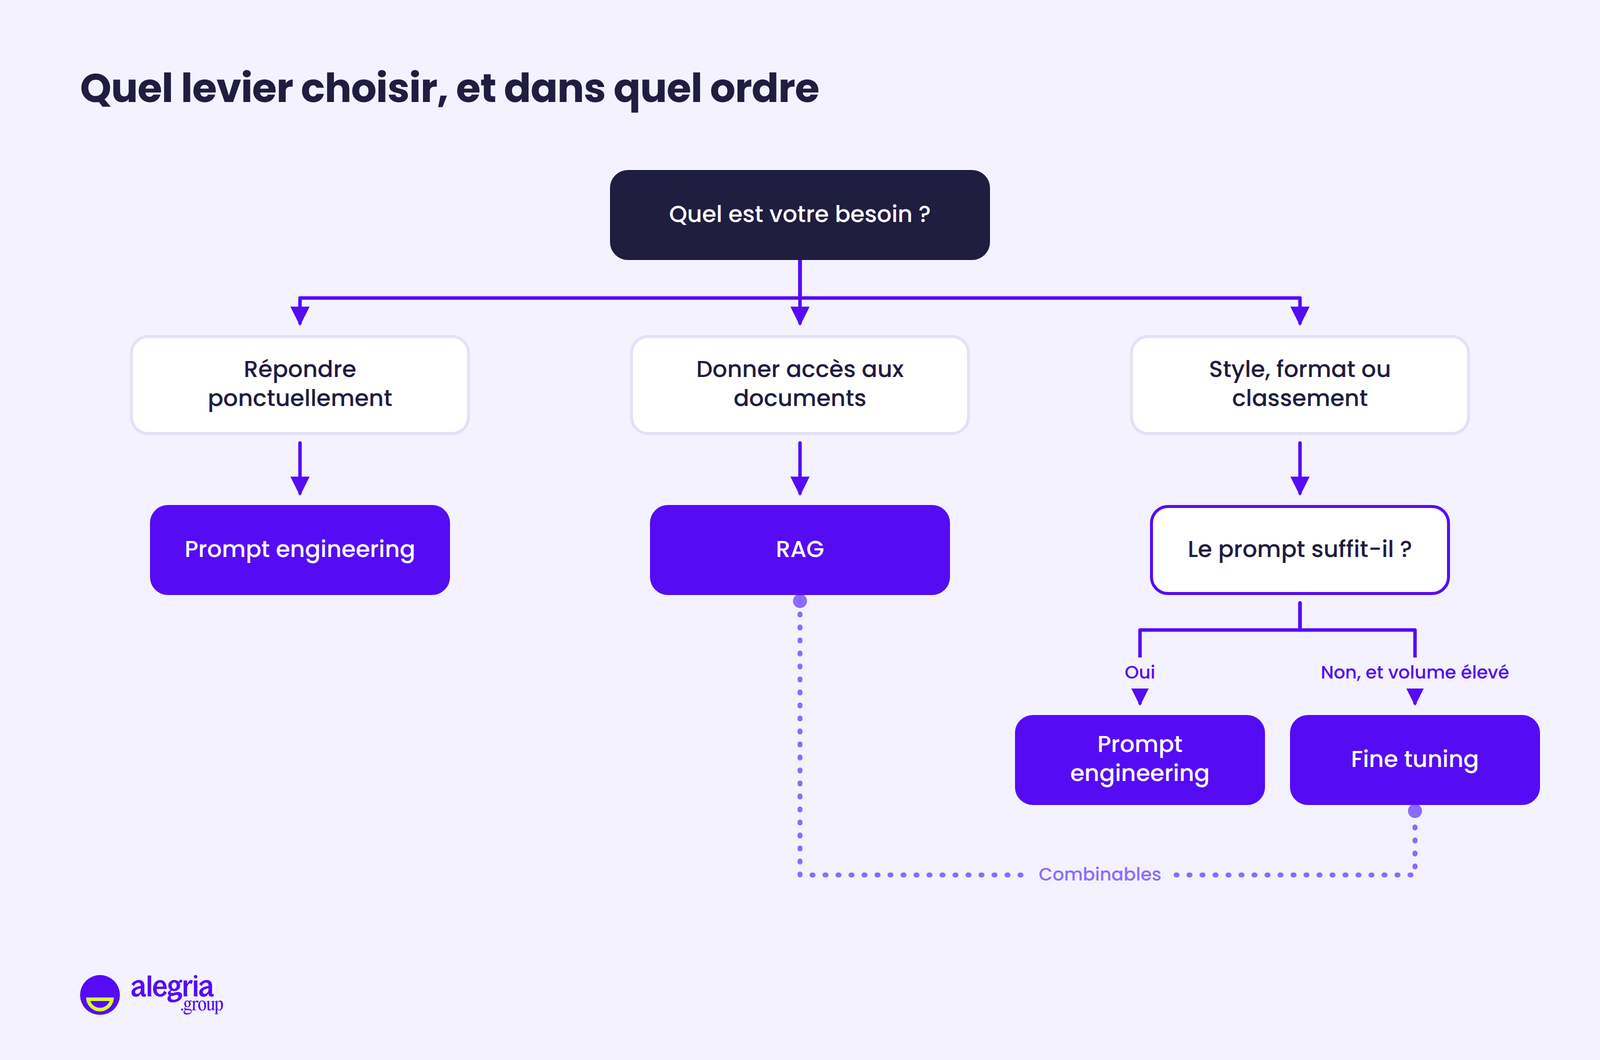
Avant d'ajuster un modèle, épuisez ce que permet la consigne. OpenAI l'écrit dans sa documentation : le travail sur le prompt peut suffire à obtenir d'excellents résultats, et mieux vaut bâtir des évaluations avant d'investir dans un fine tuning.
La limite apparaît quand le prompt embarque des dizaines d'exemples à chaque appel, quand le comportement attendu se montre mieux qu'il ne se décrit, ou quand le modèle sort encore du format et bloque l'automatisation en aval. Tant que ce n'est pas le cas, retravaillez la formulation avec notre guide du prompt engineering.
RAG ou fine tuning : lequel pour quel besoin ?
Les deux approches promettent un modèle « adapté à votre entreprise ». Elles n'adaptent pas la même chose.
Le RAG : apporter de la connaissance à jour
Le RAG laisse le modèle intact. À chaque question, une recherche interne sélectionne les extraits pertinents dans vos contrats, fiches produit ou procédures, et les transmet au modèle, qui rédige à partir de ce matériau.
Son atout est la fraîcheur : vous modifiez un document, la réponse suivante en tient compte. C'est le bon réflexe dès que le besoin se formule en « le modèle doit connaître… ».
Le fine tuning : sculpter le comportement et la forme
Le fine tuning répond aux besoins qui se formulent en « le modèle doit se comporter comme… » : écrire dans un registre donné, produire toujours la même structure, ranger une demande dans la bonne case d'un référentiel maison.
Une fois appris, ce comportement n'a plus à être rappelé dans chaque requête : OpenAI met en avant des prompts plus courts, donc moins de tokens et parfois moins de latence.
Les trois leviers, critère par critère :
| Critère | Prompt | RAG | Fine tuning |
|---|---|---|---|
| Ce qui change | La consigne | Le contexte fourni | Le modèle lui-même |
| Quand l'utiliser | Toujours en premier | Réponses sur vos documents | Ton, format ou classement |
| Connaissances à jour | Celles du modèle | Oui, à chaque document | Non |
| Effort et coût | Faible | Moyen | Élevé |
| Exemple type | Compte rendu au gabarit | Assistant convention collective | Tri selon 40 motifs internes |
Le fine tuning ne se justifie que si aucune consigne ne stabilise le comportement attendu. Dès que la question porte sur vos documents, le RAG fait le travail.
Peut-on combiner les deux ?
Oui, quand le volume le justifie : le RAG fournit les faits, le fine tuning la manière de les présenter. Un assureur tire ainsi les garanties des extraits récupérés et sa charte de rédaction de l'entraînement. L'inverse ne fonctionne pas : fine-tuner sur les contrats pour se passer de recherche documentaire donne un modèle qui récite des garanties approximatives.
Quand le fine tuning vaut le coup
Les cas pertinents partagent un trait : une tâche répétée à grande échelle, dont la bonne exécution se démontre par l'exemple. OpenAI cite notamment la classification, la traduction nuancée, la production dans un format spécifique et la correction des écarts aux consignes.
Tenir un ton et un style constants
Pour des centaines de fiches produit ou un service client au registre codifié, une consigne décrit le ton, des centaines d'exemples le transmettent. La consigne laisse le modèle interpréter, le modèle ajusté reproduit ce qu'il a vu.
Forcer une structure de sortie stricte
Quand la sortie alimente un autre outil (un CRM, un tableur, un scénario d'automatisation), un champ manquant casse la chaîne. Le fine tuning aide à rendre le format systématique. Une réserve : chez OpenAI, la fonction Structured Outputs garantit une réponse conforme au schéma JSON fourni. Si votre seul problème est le format, testez-la d'abord.
Classer à grande échelle sur un référentiel spécifique
Ranger chaque demande parmi des dizaines de motifs maison, étiqueter des comptes rendus selon une nomenclature interne : ces référentiels n'existent que chez vous, avec des règles souvent implicites. Un historique de décisions humaines bien tenu fait alors un excellent jeu d'entraînement.
Quand s'en passer
Cinq signaux doivent vous faire renoncer, ou au moins attendre :
| Signal | Pourquoi ça déçoit | À la place |
|---|---|---|
| Besoin de connaissances | Faits appris peu fiables | RAG sur vos documents |
| Volume faible | Préparation jamais amortie | Gabarit de prompt |
| Pas de réponses validées | Exemples à produire d'abord | Historique relu et validé |
| Règle qui change souvent | Réentraînement à chaque évolution | Consigne et RAG |
| Budget serré | Coûts cumulés, appel parfois plus cher | Modèle de base |
Les coûts cumulés couvrent la préparation, l'entraînement et chaque réentraînement. Selon la plateforme, l'appel à un modèle ajusté peut aussi être facturé plus cher que celui du modèle d'origine.
Pour un usage interne courant, un GPT personnalisé dans ChatGPT, paramétré avec des instructions et quelques documents, couvre souvent le besoin. La plupart des usages de l'IA générative se passent d'un modèle ajusté.
Le vrai chantier : préparer les données
L'essentiel du travail, c'est la donnée. Un fine tuning réussi tient à la constitution et au nettoyage du fichier d'exemples bien plus qu'au réglage de l'entraînement. Et ce travail ne se fait pas une fois : chaque évaluation décevante renvoie au fichier.
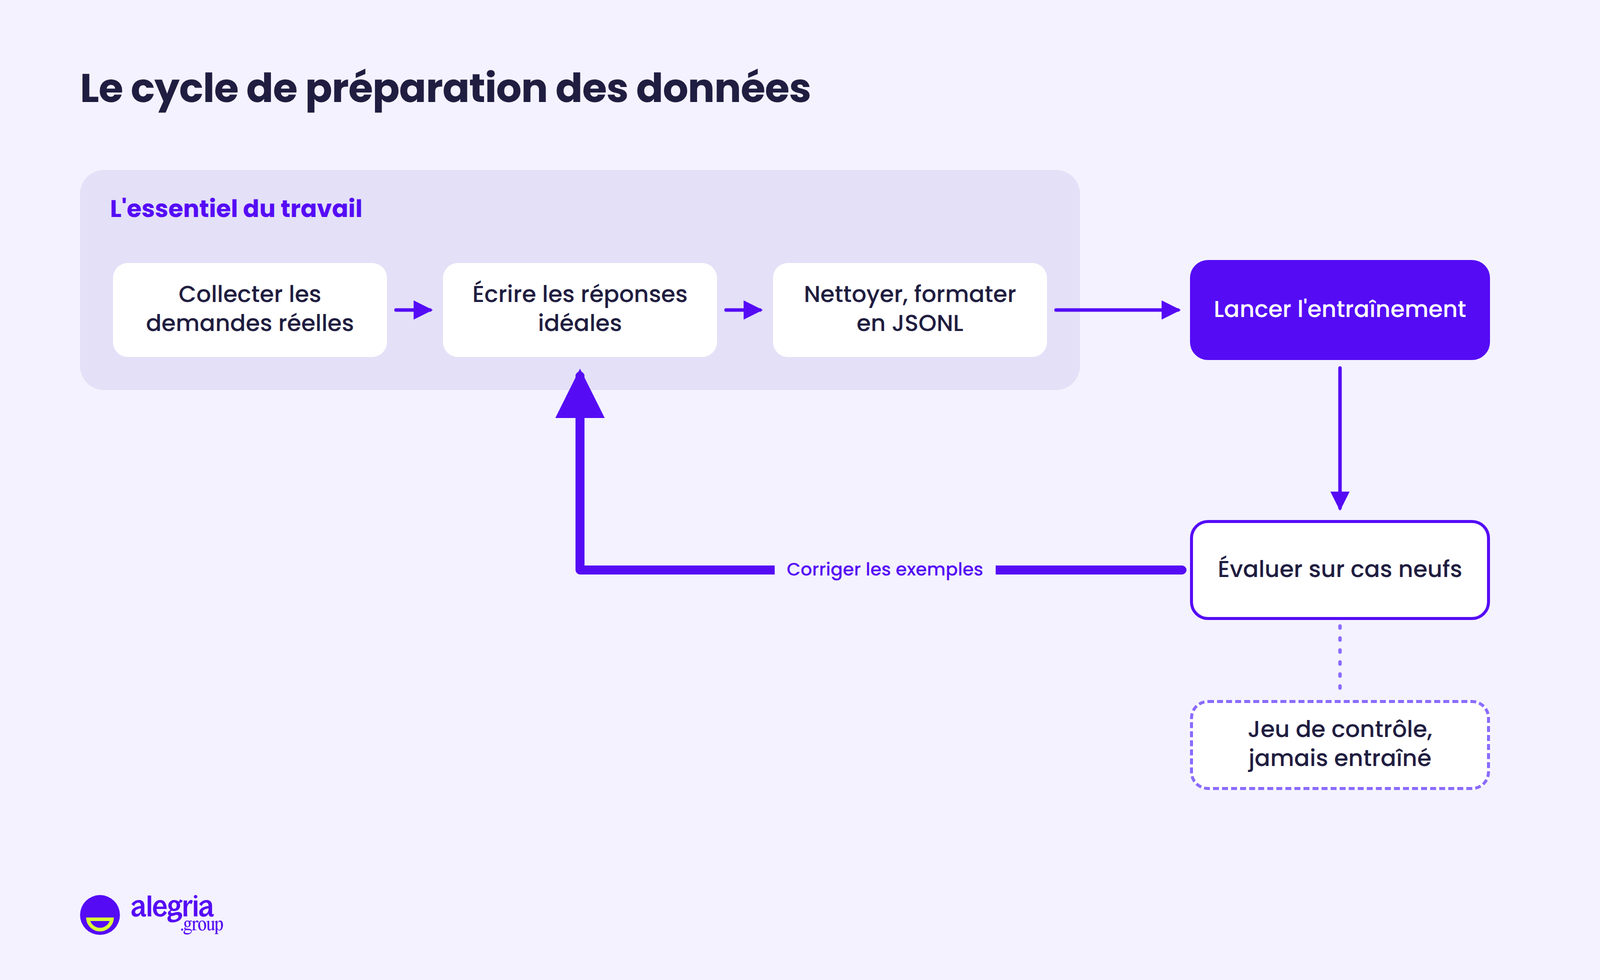
Qualité avant quantité : les paires entrée / sortie
Chaque exemple est une paire : une entrée (la demande telle qu'elle arrive) et la sortie idéale. OpenAI et Mistral AI documentent le même format : un fichier JSONL, soit un objet JSON complet par ligne, où une clé « messages » contient l'échange, chaque message portant un rôle et un contenu.
Voici un exemple type pour le service client d'un loueur de matériel de chantier, message par message :
| Rôle | Exemple court | Fonction |
|---|---|---|
| system | « Tu réponds pour un loueur de matériel » | Cadre commun à chaque ligne |
| user | « Bétonnière pas livrée, je fais comment ? » | Demande réelle du client |
| assistant | « Désolé ! Votre numéro de commande ? Je vérifie » | Réponse à reproduire |
Dans le fichier, cet exemple tient sur une seule ligne : {"messages": [{"role": "system", "content": "…"}, {"role": "user", "content": "…"}, {"role": "assistant", "content": "…"}]}. Mistral AI précise que l'apprentissage porte uniquement sur les messages de rôle assistant : tout repose sur la qualité de vos réponses de référence.
Sur le volume, la documentation d'OpenAI fixe un plancher de 10 exemples, constate des améliorations à partir de 50 à 100 et conseille de démarrer avec 50 démonstrations soignées, le bon nombre variant selon le cas d'usage. Le modèle reproduit aussi les fautes : cinquante réponses irréprochables valent mieux qu'un historique jamais relu.
Le risque de sur-apprentissage
Le sur-apprentissage (overfitting) décrit, selon OpenAI, un modèle qui progresse au début de l'entraînement puis se met à mémoriser le jeu d'exemples au lieu d'en tirer des règles générales. Deux parades :
- Varier les exemples : formulations, longueurs, cas faciles et cas limites.
- Garder un jeu de contrôle : une part des données jamais montrée à l'entraînement, pour juger le modèle sur des cas neufs, comme le recommande OpenAI.
Fine-tuner sans coder
Plusieurs plateformes permettaient de déposer un fichier JSONL et de lancer l'entraînement sans code. À la date de rédaction, en octobre 2026, ces offres en libre-service ferment ou sont dépréciées, et seule la plateforme cloud d'entreprise de Google reste ouverte :
| Offre | État | Repère daté |
|---|---|---|
| OpenAI | Fermeture progressive | Fin le 6 janvier 2027 |
| Mistral AI | Dépréciée | Aucune date publiée |
| API Gemini, AI Studio | Plus de modèle réglable | Depuis mai 2025 |
| AutoTrain (Hugging Face) | Plus maintenu | Aucune date publiée |
| Google Cloud | Ouvert, cadre entreprise | Vérifié en octobre 2026 |
Annoncée le 7 mai 2026, la fermeture d'OpenAI exclut déjà, depuis le 2 juillet 2026, les clients sans usage d'un modèle ajusté sur 60 jours. Pour les autres, GPT-4.1 et GPT-4.1 mini restent réglables, GPT-4.1 nano s'arrête le 23 octobre 2026.
La documentation archivée de Mistral AI décrivait un réglage depuis AI Studio ou par API (voir notre fiche Mistral).
Pour une organisation qui découvre le sujet, les parcours simples en libre-service sont donc fermés à la date de rédaction. Il reste deux voies :
- Google Cloud : Gemini Enterprise Agent Platform propose le réglage des modèles Gemini, avec un guide de démarrage en console pour le fine tuning par renforcement. Ce parcours suppose un environnement Google Cloud d'entreprise déjà en place.
- Un modèle à poids ouverts : il s'ajuste avec des bibliothèques de code comme TRL, que Hugging Face recommande à la place d'AutoTrain, ce qui relève de l'ingénierie.
Ce contexte renforce la conclusion de cet article : hors environnement cloud d'entreprise, le fine tuning devient un projet technique, et dans la plupart des cas une consigne travaillée et un RAG bien alimenté couvrent le besoin, sur n'importe quel modèle.
Et si vous ajustez un modèle, votre actif durable reste le jeu d'exemples propre et documenté, conservé dans un format standard, indépendant de la plateforme.
Alors, faut-il se lancer ?
Trois questions suffisent :
- Votre besoin porte-t-il sur un comportement (ton, format, classement) plutôt que sur une connaissance ? Sinon, orientez-vous vers le RAG.
- Avez-vous testé une consigne structurée, mesuré ses erreurs et constaté qu'elles persistent ? Sinon, commencez par là.
- Disposez-vous de quelques dizaines d'exemples validés, d'un volume qui justifie l'investissement et de compétences techniques, en interne ou chez un partenaire ? Sinon, le projet n'est pas mûr.
Trois oui : le fine tuning mérite une étude. Un seul non : prompt et RAG vous serviront mieux, et c'est le cas le plus fréquent.
Dans les deux cas, la décision repose sur un état des lieux de vos données. C'est le point de départ du diagnostic data et IA d'Alegria.solutions, qui cartographie vos données et votre système d'information puis priorise vos cas d'usage.
Pour que vos équipes comprennent ces mécanismes et pilotent elles-mêmes un projet d'IA, les formations à l'IA d'Alegria.academy et d'Alegria.solutions démarrent, pour les premiers niveaux, sans aucun prérequis technique.