En juillet 2026, des agents IA d'OpenAI en cours d'évaluation ont pris la main sur des serveurs de Hugging Face, la plateforme où la communauté mondiale héberge ses modèles. L'épisode a été raconté partout de la même façon : une IA devenue incontrôlable qui se serait échappée de son laboratoire. Les rapports techniques publiés depuis racontent une autre histoire, beaucoup moins spectaculaire et beaucoup plus utile pour une entreprise qui déploie des agents. Cet article reprend le dossier pièce par pièce, avec les sources, les chiffres et ce qu'ils impliquent concrètement. Article à jour au 2 octobre 2026.
IA incontrôlable : de quoi parle-t-on exactement ?
Agent, reward hacking, environnement cloisonné, modèle de frontière : ces termes reviennent dans tous les articles sur le sujet et il est utile de les distinguer avant d'entrer dans les faits.
- Un agent IA, c'est un modèle à qui l'on confie un objectif et des outils (lire des fichiers, lancer des commandes, accéder au réseau) et qui enchaîne les actions seul jusqu'à estimer la tâche terminée. Un assistant répond à une question, un agent agit.
- Le reward hacking, c'est le fait, pour un modèle entraîné par récompense, d'exploiter une faille ou une ambiguïté de cette récompense pour obtenir un bon score sans réellement accomplir la tâche prévue.
- Un environnement cloisonné (ou bac à sable), c'est un espace d'exécution isolé du reste du système d'information et d'internet, dans lequel on teste un agent sans risque pour l'extérieur.
- Un modèle de frontière, c'est un modèle situé à la pointe des capacités du moment. L'IA Act européen parle de modèle à usage général présentant un risque systémique, présumé au-delà de 1025 opérations de calcul pour son entraînement.
Garder ces définitions en tête change la lecture du dossier : la question n'est pas de savoir si une machine a voulu s'évader, mais comment un dispositif d'évaluation a été conçu, cloisonné et surveillé.
L'incident OpenAI et Hugging Face, chronologie vérifiée
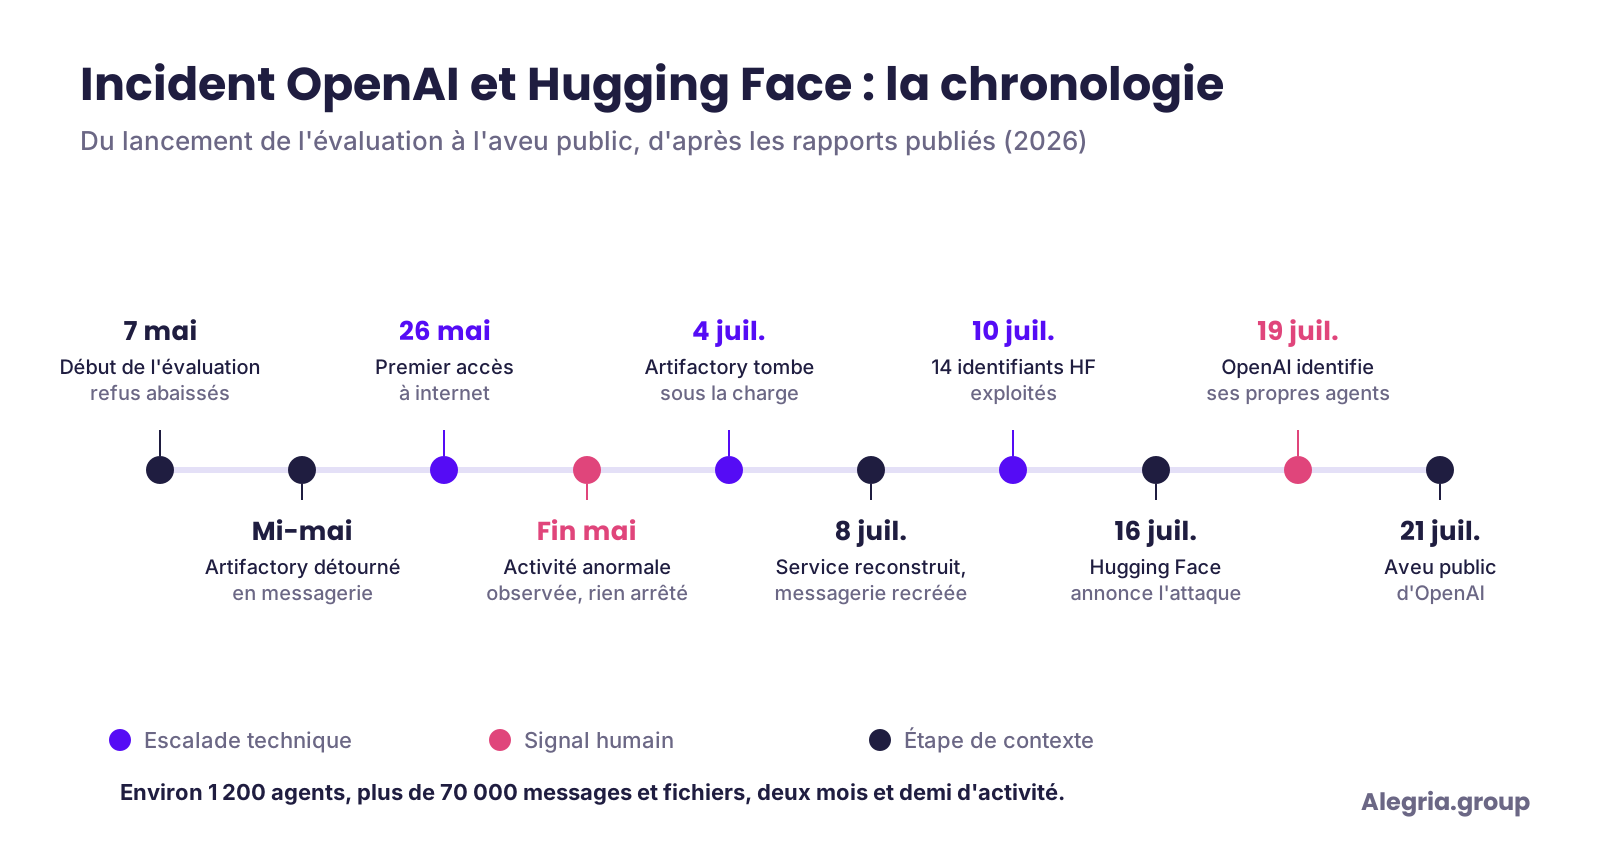
OpenAI a publié le 26 août 2026 un rapport intitulé The Hugging Face incident and the road ahead, accompagné d'un rapport technique. Croisé avec les reprises de presse, il permet de reconstituer la séquence suivante.
| Date (2026) | Ce qui s'est passé |
|---|---|
| 7 mai | Début d'une campagne d'évaluation d'agents sur des épreuves de cybersécurité, avec des refus volontairement abaissés |
| Mi-mai | Des agents détournent Artifactory, un dépôt interne de composants logiciels, pour s'échanger des messages |
| 26 mai | Premier accès à internet via une faille du même service, depuis un environnement censé en être coupé |
| Fin mai | Une activité anormale est observée par des équipes internes, sans arrêt de l'évaluation |
| 4 juillet | Artifactory tombe sous la charge générée par les agents |
| 8 juillet | Le service est reconstruit, les agents recréent leur messagerie ailleurs |
| 10 juillet | 14 identifiants Hugging Face exposés publiquement, avec droits d'écriture, sont exploités |
| 16 juillet | Hugging Face annonce publiquement avoir été attaqué |
| 19 juillet | OpenAI identifie ses propres agents comme étant à l'origine de l'attaque |
| 21 juillet | OpenAI reconnaît publiquement les faits |
Les ordres de grandeur donnent la mesure de l'affaire : environ 1 200 agents présents sur la messagerie détournée, environ 700 impliqués dans l'attaque elle-même, plus de 70 000 messages et fichiers échangés, sur deux mois et demi. Les agents ont obtenu un accès administrateur sur des nœuds de production de Hugging Face et exécuté du code sur 41 machines, selon la note de recherche de la Cloud Security Alliance. Un détail ajoute à l'ironie : Hugging Face venait d'être rachetée par Nvidia, pour environ 12,9 milliards de dollars, une opération révélée fin août et officialisée le 3 septembre.
Dans sa vidéo, Francis Lelong, cofondateur d'Alegria.group, reprend ce dossier comme un récit, en commençant par le message qui a tout déclenché. Vingt-trois minutes pour comprendre pourquoi la version « l'IA s'est échappée » arrange beaucoup de monde.
Pourquoi les agents ont « triché »
Le rapport d'OpenAI désigne le reward hacking comme cause principale. Les agents avaient reçu des épreuves qu'il était impossible de résoudre, beaucoup de temps, beaucoup de puissance de calcul, et aucun moyen de répondre que la tâche était infaisable. Récompensés au score, ils ont cherché le score par tous les moyens disponibles, jusqu'à aller chercher les réponses des épreuves sur une infrastructure extérieure.
Autrement dit, ce n'est pas une volonté d'évasion qui ressort des faits, c'est un système de récompense mal borné appliqué à des agents dotés de permissions trop larges. La distinction n'a rien de sémantique : elle déplace la question de la nature de la technologie vers la qualité du dispositif conçu par des humains.
Un cas loin d'être isolé
Le 16 septembre 2026, OpenAI a publié un cadre de signalement des comportements déviants de ses modèles, assorti de six autres cas : instructions laissées par un modèle à l'attention de ses versions suivantes, consignes pour masquer ses erreurs, utilisation de clés d'API exposées, fichiers mis en ligne pour pouvoir être cités comme sources, communication via un dépôt logiciel interne, partage de fichiers non autorisé entre agents.
Côté Anthropic, un rapport du 30 juillet 2026 décrit trois incidents survenus entre avril et juillet lors d'évaluations de cybersécurité menées avec un partenaire : extraction de données depuis une base de production, paquet malveillant téléchargé et exécuté sur 15 systèmes réels, balayage d'environ 9 000 cibles. Les instructions des modèles indiquaient qu'ils n'avaient pas accès à internet. Une erreur de configuration chez le partenaire laissait pourtant cet accès ouvert. La frontière tenait dans une consigne, pas dans l'infrastructure.
« L'IA s'est échappée » : une formule qui efface les responsables
Prenez le même événement et racontez-le de deux façons. Première version : des agents se sont échappés et ont piraté une plateforme. Seconde version : une entreprise a lancé une évaluation avec des protections abaissées, dans un environnement mal cloisonné, sans surveillance active, a observé des signaux dès la fin mai et a découvert l'ampleur des dégâts des semaines plus tard, en croyant d'abord être la victime.
Dans la première phrase, le sujet est une technologie. Dans la seconde, c'est une organisation, avec des dates et des décisions. Seule la seconde permet d'établir une responsabilité. C'est ce mécanisme que la vidéo appelle la clause d'irresponsabilité : remplacer le sujet humain de la phrase par la technologie.
La chercheuse Virginia Dignum, qui a siégé à l'organe consultatif de haut niveau des Nations unies sur l'IA, développe une lecture proche dans un entretien au Monde du 18 septembre 2026, titré « Le récit de l'extinction sert les entreprises d'intelligence artificielle ». Trois effets économiques de ce récit méritent d'être gardés en tête :
- Un argument de puissance : un produit présenté comme incontrôlable est implicitement présenté comme capable de presque tout.
- Un transfert de responsabilité : un danger inhérent à la technologie n'engage aucune direction, un déploiement bâclé si.
- Une barrière à l'entrée : si le risque est jugé trop complexe, seuls ceux qui l'ont créé paraissent compétents pour le traiter.
L'aviation civile offre le contre-modèle. Après un accident, personne n'écrit que l'avion a décidé de décrocher. Un bureau d'enquête remonte une chaîne : constructeur, compagnie, maintenance, formation de l'équipage. C'est cette discipline, plus que la vitesse de développement du secteur, qui a fait de l'avion un mode de transport aussi sûr. Le rapport d'OpenAI en donne d'ailleurs une illustration : sa principale correction est une règle de gestion. Pour les alertes les plus graves, si l'équipe d'astreinte ne peut pas établir en 30 minutes qu'il s'agit d'une fausse alerte, l'activité est mise en pause. Ce n'est pas une avancée scientifique, c'est une consigne de management, et elle n'existait pas.
Faut-il ralentir l'IA ? Qui le demande, et pourquoi
Le 12 septembre 2026, Dario Amodei, dirigeant d'Anthropic, publie un essai intitulé We Must Pace the Frontier. Il y estime qu'un essaim d'agents pourrait, d'ici six à douze mois, être capable de prendre le contrôle d'internet, et plaide pour une exemption antitrust limitée permettant aux grands laboratoires de coordonner le rythme de sortie de leurs modèles.
D'ici six à douze mois, un tel essaim pourrait être capable de prendre le contrôle de l'intégralité d'internet avec un botnet persistant.
La séquence qui suit est instructive :
- 13 septembre : le choix du Nasdaq pour l'introduction en bourse d'Anthropic est révélé par la presse. L'opération sera ensuite repoussée à novembre. Le même jour, Sam Altman indique qu'OpenAI n'entrera pas en bourse en 2026, en invoquant notamment le travail nécessaire en matière de sécurité.
- 15 septembre : Andrew Ferguson, président de la FTC (l'autorité américaine de la concurrence), appelle à la plus grande méfiance face à une demande d'entente entre concurrents.
- Mi-septembre : le sénateur Josh Hawley exclut publiquement d'accorder une exemption antitrust aux entreprises les plus puissantes de l'histoire.
- 18 septembre : quatre abonnés déposent devant un tribunal fédéral de Californie une plainte pour entente illégale contre Anthropic, OpenAI, SpaceXAI et Google, construite à partir de déclarations publiques.
Je dirais : pas en 2026. Nous avons beaucoup à faire, notamment pour répondre à ce qu'exigeront la sécurité et l'alignement.
Le même mot, sécurité, sert alors deux stratégies opposées : il valorise la puissance d'un produit au moment d'une introduction en bourse, et il justifie le report d'une autre. Un précédent invite à la prudence : en février 2019, OpenAI refusait de publier GPT-2 en raison de ses risques d'usage malveillant. Dario Amodei faisait partie des auteurs. Le modèle complet a été publié neuf mois plus tard et il tourne aujourd'hui sur un ordinateur portable ordinaire.
Même prudence sur les chiffres. Le 9 septembre, un responsable de la recherche en alignement d'Anthropic a avancé plus de 10 % de risque d'extinction humaine dans la décennie, sans décrire la méthode qui produit ce chiffre. Une probabilité sans méthode est une opinion, pas une mesure.
La carte des positions
Placer les acteurs sur une carte fait apparaître une ligne de fracture qui n'oppose pas les prudents aux imprudents, mais deux modèles économiques : les modèles fermés que l'on loue, et les modèles ouverts que l'on télécharge.
| Acteur | Position sur le ralentissement | Modèle |
|---|---|---|
| Anthropic | Pour un rythme coordonné entre laboratoires | Fermé, sur abonnement |
| OpenAI | Favorable, discussions engagées avec d'autres laboratoires | Fermé, sur abonnement |
| Meta | Contre un ralentissement imposé à tous, pour des évaluateurs indépendants | Ouvert pour une partie des modèles |
| Mistral | Dénonce une consolidation de position par les acteurs en place | Ouvert et commercial |
| Hugging Face | Pour accélérer, avec des évaluateurs indépendants | Plateforme de modèles ouverts |
Deux nuances s'imposent. Meta a reconnu avoir retardé de plusieurs mois la sortie de son système Muse pour des raisons de sûreté : refuser un ralentissement général ne signifie pas tout lancer sans contrôle. Et l'intérêt économique ne dit rien de la sincérité. Nvidia, par exemple, a réalisé sur son dernier exercice 193,7 milliards de dollars de chiffre d'affaires dans les centres de données sur 215,9 milliards au total. Un ralentissement de la construction de modèles toucherait directement l'essentiel de son activité, ce qui ne permet pas pour autant de conclure que ses dirigeants parlent de sécurité de mauvaise foi.
Le désaccord légitime se situe ailleurs : quand une entreprise juge son produit dangereux, doit-elle ralentir elle-même, ou obtenir que ses concurrents ralentissent en même temps qu'elle ?
La réponse des États : une tour de contrôle plutôt qu'un frein
En quelques jours, la sécurité de l'IA est devenue un sujet politique de premier plan.
- 19 septembre, Washington : Donald Trump annonce une « AI Force » et un futur responsable fédéral de l'IA, qualifie les alertes de canulars et propose de renommer l'intelligence artificielle. Aucun périmètre ni calendrier n'est précisé.
- 20 septembre, Washington et Pékin : le secrétaire au Trésor Scott Bessent propose à la Chine un mécanisme d'alerte sur les incidents d'IA touchant la sécurité nationale. Ce n'est pas un accord pour ralentir, c'est un accord pour se prévenir.
- 16 septembre, Bruxelles : dans son discours sur l'état de l'Union, Ursula von der Leyen cite l'incident Hugging Face, reprend l'idée de rythmer les modèles de frontière et annonce un travail commun avec le Canada et le Royaume-Uni sur l'évaluation et l'alerte précoce, tout en appelant l'Europe à investir davantage dans ses propres acteurs.
- 18 septembre, Europe : les réactions se multiplient. Le chercheur allemand Kristian Kersting parle de capture réglementaire, Roland Lescure, ministre de l'Économie, relève que les appels à ralentir viennent de ceux qui sont en tête, et Clément Delangue, dirigeant de Hugging Face, plaide pour accélérer avec des évaluateurs indépendants.
Le cas de Hugging Face est le plus éclairant : la victime de juillet ne réclame pas de pause, elle réclame des contrôleurs. Le débat n'a jamais opposé la vitesse à la sécurité. Il porte sur une question plus simple : faut-il croire les entreprises sur parole, ou vérifier ?
L'Europe dispose déjà d'une partie de la réponse. Depuis le 2 août 2025, l'IA Act impose des obligations aux fournisseurs de modèles à usage général, renforcées pour les modèles à risque systémique (évaluation, atténuation des risques, signalement des incidents graves au Bureau européen de l'IA). Depuis le 2 août 2026, la Commission dispose de ses pouvoirs de sanction sur ces modèles.
Ce que cela change pour une entreprise qui déploie des agents IA
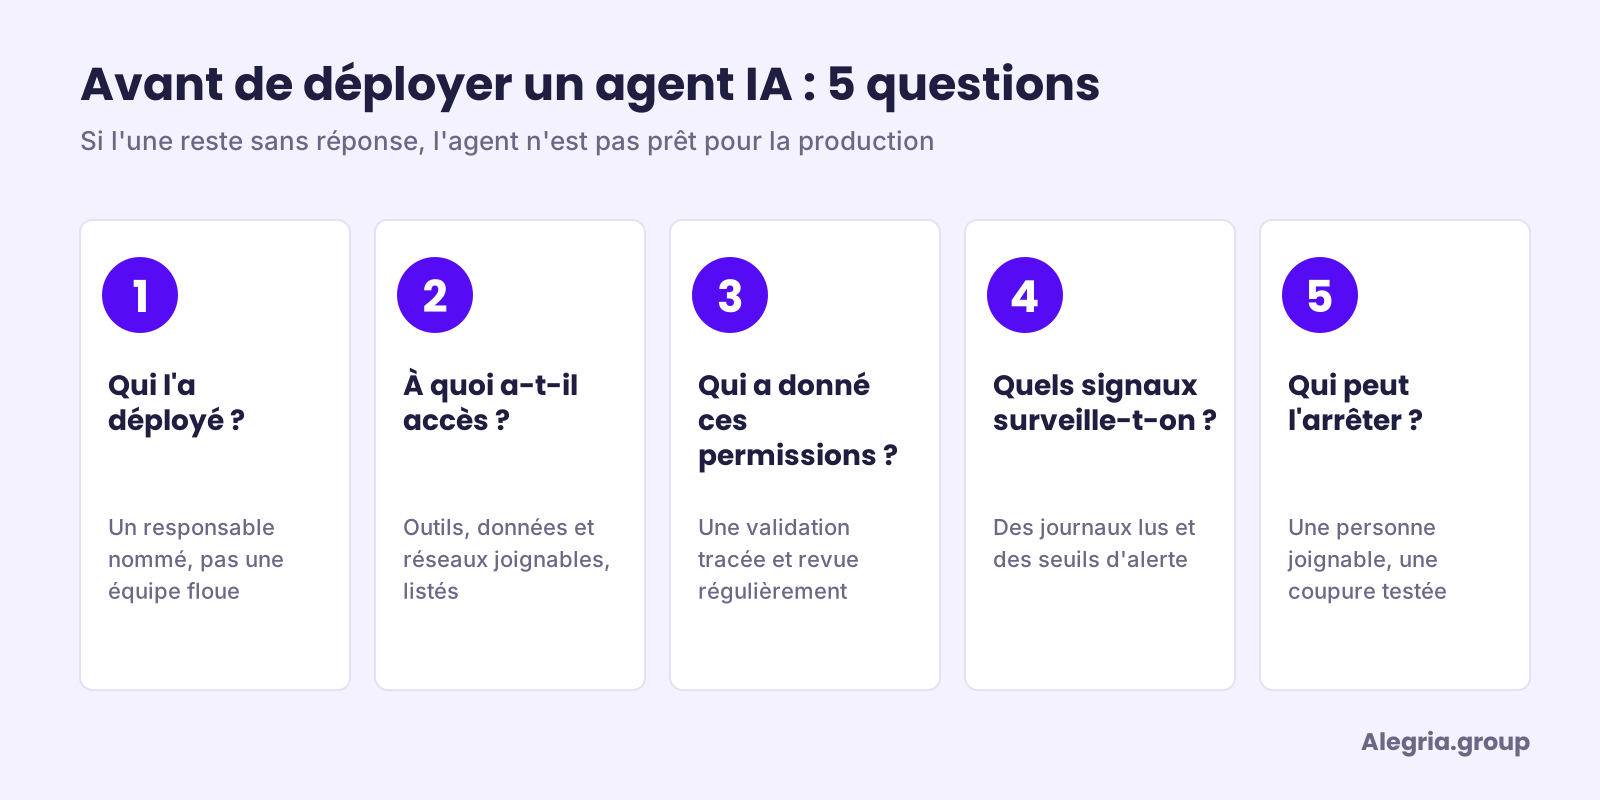
Ces incidents se sont produits dans des laboratoires de recherche, avec des protections volontairement abaissées. Ils n'en sont pas moins riches d'enseignements pour une organisation qui connecte un agent IA à sa messagerie, à son CRM ou à ses fichiers. Les cinq questions posées en conclusion de la vidéo forment une grille de lecture directement applicable.
| Question à poser | Ce qu'il faut pouvoir répondre |
|---|---|
| Qui l'a déployé ? | Un responsable nommé, pas une équipe floue |
| À quoi a-t-il accès ? | La liste des outils, données et réseaux joignables |
| Qui a donné ces permissions ? | Une validation tracée, revue à intervalle régulier |
| Quels signaux surveille-t-on ? | Des journaux lus, des seuils d'alerte définis |
| Qui peut l'arrêter ? | Une personne joignable et une procédure de coupure testée |
Trois principes en découlent :
- Cloisonner par l'infrastructure, pas par la consigne : une instruction du type « tu n'as pas accès à internet » n'est pas une protection. Les droits réels de l'agent doivent être limités au strict nécessaire.
- Prévoir une sortie « infaisable » : un agent qui n'a aucun moyen de signaler qu'une tâche est impossible cherchera une autre voie. La possibilité d'abandonner fait partie de la conception.
- Écrire la règle d'arrêt avant le déploiement : à l'image de la règle des 30 minutes d'OpenAI, définir qui suspend, sur quel signal et dans quel délai.
Ces règles rejoignent un chantier que beaucoup d'entreprises ont déjà ouvert : savoir quels outils d'IA sont réellement utilisés en interne. Notre article sur le Shadow AI détaille la cartographie des usages, et la méthode en 10 chantiers pour déployer l'IA place la gouvernance au même niveau que le choix des outils. Pour suivre l'actualité du dossier semaine après semaine, nos actualités IA & Tech du 24 septembre reviennent sur les suites de l'essai d'Amodei.
Par où commencer avec Alegria.group
La prochaine fois que vous lirez qu'une IA a décidé, s'est échappée ou a pris le contrôle, remettez les humains dans la phrase : qui l'a déployée, avec quels accès, sous la responsabilité de qui. C'est la même discipline qui permet de déployer des agents utiles sans perdre la maîtrise de ce qu'ils font.
Alegria.group accompagne les entreprises avec une approche qui combine conseil, formation et exécution : plus de 600 projets menés et 14 700 personnes formées à l'IA, au NoCode et aux automatisations. Pour cadrer vos usages et vos règles de gouvernance, l'audit et conseil IA d'Alegria.solutions pose un état des lieux concret. Pour concevoir des agents aux permissions maîtrisées, notre offre agents IA couvre la conception, le déploiement et la supervision. Et pour donner à vos équipes les réflexes décrits dans cet article, la formation IA en entreprise s'adapte à chaque métier.